// 跨越商业变现的生死线
将昂贵的算力,转化为
高效且澎湃的 Token 产能。
专注工业级 AI 推理加速与异构算力部署。从存量老卡的“无损续命”,到万卡集群的 P-D 彻底分离重构;我们跨越 CUDA、CANN、ROCm 等底层计算框架生态,深入异构算子与显存微操,为您打破算力瓶颈,打造最高产的自动化流水线。
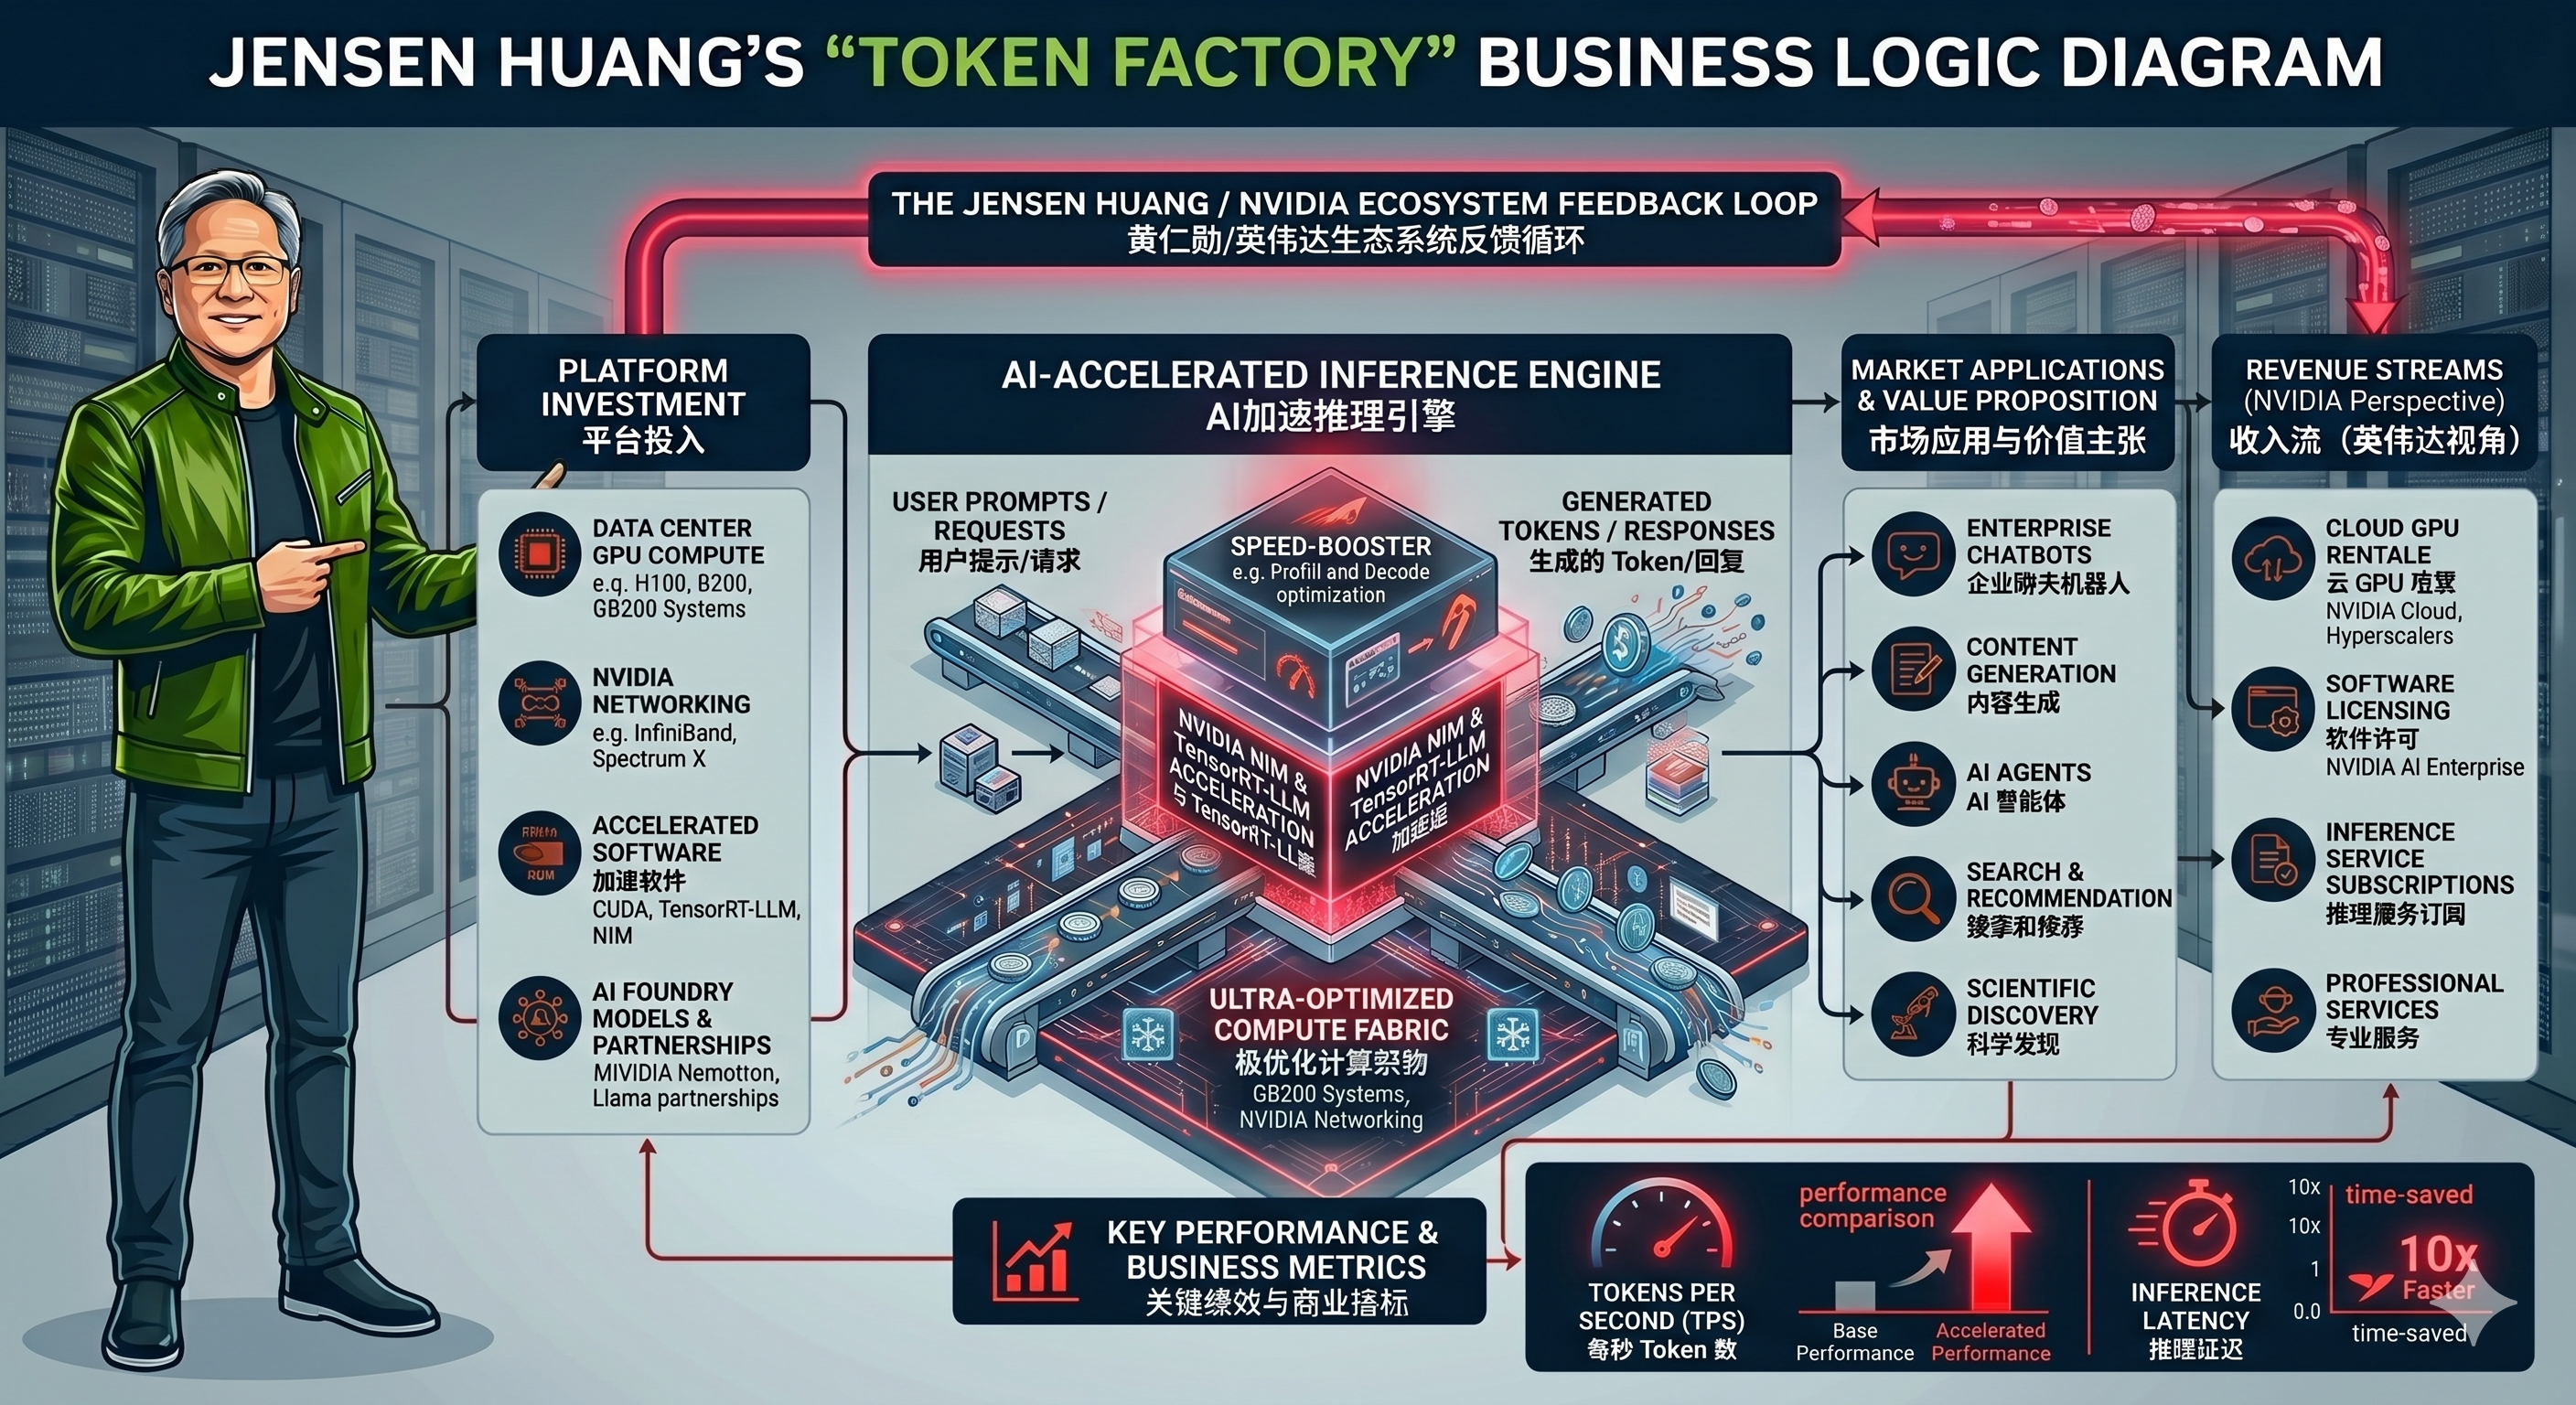
00. 宏观蓝图:Token 工厂的盈利飞轮
正如 NVIDIA 倡导的生态逻辑,未来的 AI 企业本质上都是“Token 工厂”。在这个商业闭环中,深度优化的推理引擎 (Ultra-Optimized Compute Fabric) 是阻断算力浪费、连接昂贵硬件投入与最终商业变现的唯一枢纽。
01. 核心破局场景
存量历史资产“续命”计划
让数年前的沉默资产,跑起今天最前沿的千亿大模型。面对 70B 乃至超大 MoE 架构,前代芯片严重受制于“显存墙”,面临淘汰风险。
- ▹ 极致无损量化: AWQ/W4A16 降维压缩,单卡吞下大模型。
- ▹ 算子逆向移植: 跨越架构代差,重新激活旧硬件的 IO 加速。
- ▹ 显存卸载调度: 动态权重加载,保护客户历史资产。
超级 Token 工厂深度重构
消除万卡集群的算力黑洞。节点间遭遇的“通信墙”越发严峻,跨节点网络拥塞导致整体有效利用率(MFU)呈现断崖式暴跌。
- ▹ P-D 彻底物理分离: 首发计算与后续生成独立池化。
- ▹ 全局拓扑调度: 重构 RDMA 路由,消除跨节点通信拥堵。
- ▹ TokenDN 异构多机: 兼容国产计算生态,化身造币厂。
02. 全栈算力破局沙盘 (Interactive Sandbox)
亲手拨动参数,直观推演底层物理瓶颈,见证深度优化引擎如何打破内存墙与通信墙。
硬件与业务基建
中网数据港深度优化引擎
03. 跨越内存墙的技术引擎
* 核心引擎:底层算子重写与融合 (Operator Rewriting)
* 目标:解决 Attention 机制的 HBM 带宽瓶颈
======================================================== */
// 1. 寄存器级数据驻留:强制融合 RoPE、RMSNorm 等零碎算子
#pragma unroll
for (int i = 0; i < BLOCK_SIZE; ++i) {
compute_qkv_and_fuse_norm(); // 显存读写请求下降 60%
}
// 2. 异构底层对齐:无缝调度 NVIDIA、华为昇腾等多框架硬件指令
dispatch_to_heterogeneous_tensor_cores();
}
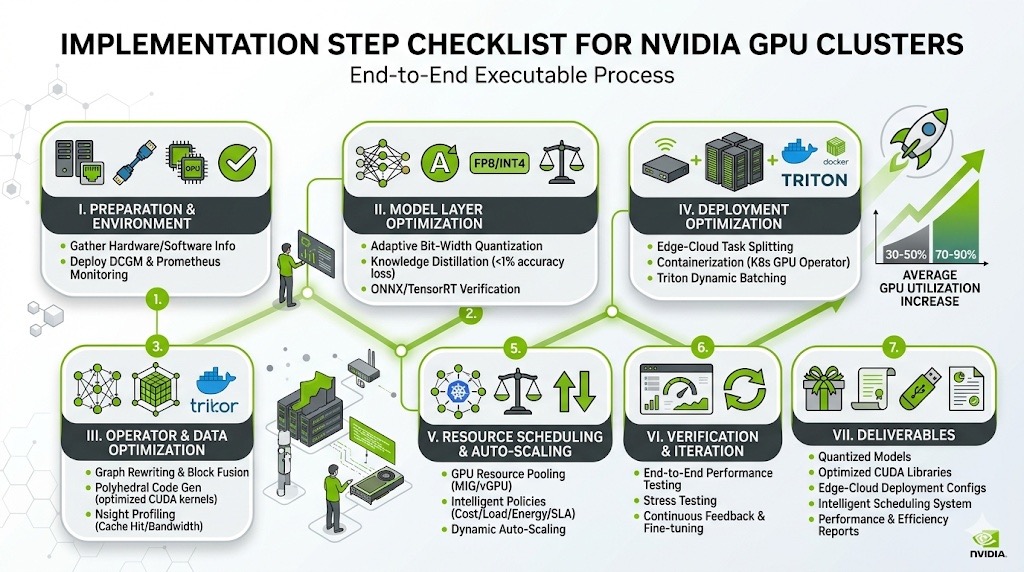
04. 工业级标准化交付路径
拒绝黑盒作业。我们严格遵循端到端的算力重构 SOP,从环境基建到模型层、算子层深度微调,最终输出可量化的性能质检报告。
05. 工业级交付基线:对标顶级大厂的外采 SLA
Token 产能的每一秒都与营收直接挂钩。我们的算力交付不仅追求极限 Benchmark,更严格遵守业内最严苛的生产级验收标准。
极速响应与吞吐红线
显存与缓存压榨
高可用与灾备调度
开发者生态无缝对齐 (Developer Ecosystem)
原生支持完整 OpenAI Chat API 协议与 SSE 流式返回。即插即用,零适配负担。
不空谈理论,只解决性能瓶颈。
提交您的硬件配置与业务线规模,获取精确到 Token 的算力体检报告与底层重构方案。